オブザーバビリティ導入ガイド
概要
このガイドは、組織が 3 つの導入ステージを通じてオブザーバビリティ機能を評価し進化させるための構造化されたフレームワークを提供します。また、コストがかかり脆弱なオブザーバビリティ実装につながる一般的なアンチパターンや落とし穴も特定します。特に、時間と予算の制約が厳しい状況で発生しやすいものです。
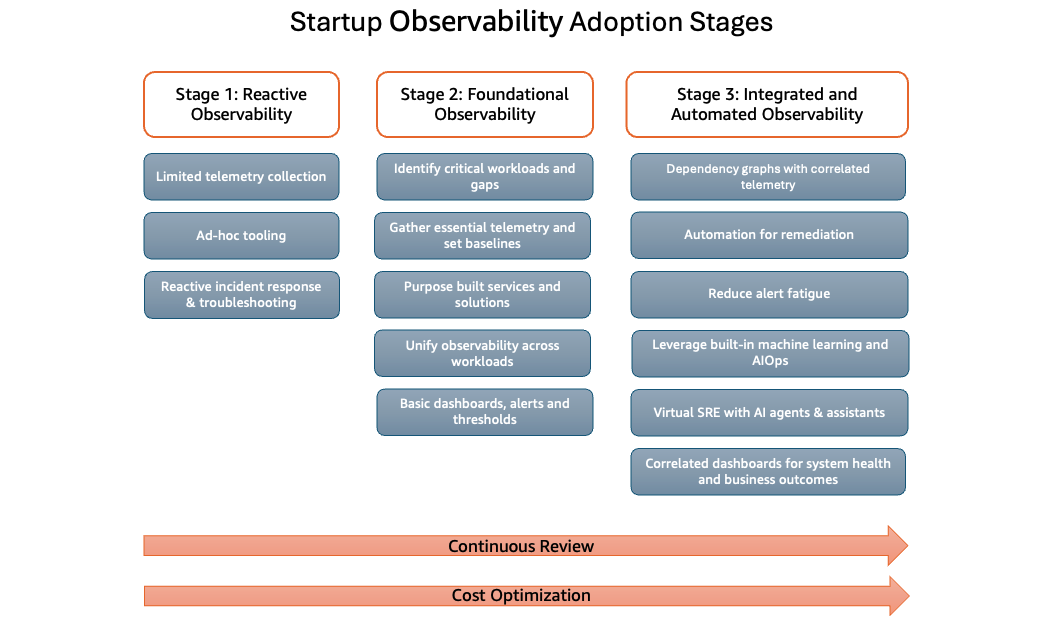
このフレームワークは、リアクティブなモニタリングから統合された自動化されたオブザーバビリティまでをカバーし、各ステージが前のステージの上に構築されて運用可視性を向上させます。すべてのステージを通じて、組織は基本原則として継続的なレビューとコスト最適化に焦点を維持する必要があります。
使用するタイミング
- 初めてオブザーバビリティプラクティスを確立する成長中の組織である場合
- 成熟度フレームワークに対してオブザーバビリティ機能がどこに位置するかを理解したい場合
- 成長の各ステージで何を優先すべきかのガイダンスが必要な場合
- 予算の無駄遣いや技術的負債を生む一般的な落とし穴を回避したい場合
- アドホックなモニタリングツールから統一されたオブザーバビリティプラットフォームに移行している場合
- 制約のあるリソースに対してオブザーバビリティ投資のバランスを取る必要がある場合
ガイダンス
ステージ 1:リアクティブオブザーバビリティ
これは、オブザーバビリティプラクティスが主にリアクティブである大半の組織のスタートポイントです。チームは通常、制約されたリソースで運用し、主に直近の運用ニーズに焦点を当てています。
主な特徴:
- 限定的なテレメトリ収集: 基本的なメトリクス、ログ、トレースは収集されますが、カバレッジは不完全で一貫性がありません。データ収集は散発的であるか、最も重要なコンポーネントにのみ焦点を当てている場合があります。
- アドホックなツール: モニタリングソリューションは必要に応じて実装され、断片化されたツールセットになります。チームは、標準化されていない無料ティアのオファリング、オープンソースソリューション、または統合が限定された組み込みのクラウドプロバイダーツールに依存する場合があります。
- リアクティブなインシデント対応: 問題はプロアクティブな検出ではなく、顧客からの苦情やシステム障害を通じて発見されます。トラブルシューティングは手動で時間がかかり、個人の知識に依存します。
一般的な課題:
- 検出までの平均時間(MTTD)と解決までの平均時間(MTTR)の延長
- 問題の再現と診断の困難さ
- トレンド分析のための履歴データの不足
- エンジニアリングチーム内のナレッジサイロ
ステージ 2:基盤オブザーバビリティ
このステージは、リアクティブなアプローチから意図的なオブザーバビリティ戦略への移行を示します。組織は体系的なアプローチの実装を開始し、スケーラブルなプラクティスの基盤を確立します。
主な特徴:
-
重要なワークロードとギャップの特定 — 重要なワークロード(カスタマーエクスペリエンス、収益、またはコアオペレーションに最も影響を与えるシステム)を定義し、既存のギャップを分析します。重要なフローを定義し、関連するサービスと依存関係をマッピングし、オーナーを割り当て、主要な技術シグナル(レイテンシー、エラー、使用率)を定義し、カバレッジが不足している箇所をフラグするチェックリストを作成します。
-
必須テレメトリの収集とベースラインの設定 — 3 つのカテゴリにわたって一貫したメトリクスを追跡します:
- コアサービスヘルス: CPU、メモリ、DB 接続、p95/p99 レスポンスタイム、毎秒リクエスト数、4xx/5xx エラー率
- 信頼性と可用性: アップタイムと SLO、インシデントメトリクス(MTTR、アラートボリューム)、顧客影響指標
- プロダクトおよびビジネスメトリクス: 収益レート、トランザクション成功率、チャーンとリテンション、アクティブセッション、テナントあたりのコスト
-
専用サービスの活用 — マネージド AWS オブザーバビリティプラットフォームにより、運用オーバーヘッドが削減されます。Amazon CloudWatch によるメトリクスとログに AWS X-Ray による分散トレーシングを組み合わせることで、最小限の設定で深いリアルタイムの可視性が得られます。従量課金制の料金体系と、モニタリングインフラストラクチャの管理が不要になることによるコスト削減により、チームはプロダクト機能に集中できます。
-
ワークロード全体のオブザーバビリティの統一 — 共有データモデル、一貫した命名規則、OpenTelemetry などの標準フレームワークを通じてテレメトリを標準化します。Amazon CloudWatch のような拡張可能なプラットフォームを採用することで、単一の信頼できる情報源が提供され、ビジネスのスケールに伴うインシデント検出の迅速化がサポートされます。
-
基本的なダッシュボード、アラート、しきい値の確立 — CloudWatch は、コア AWS サービスのメトリクス、しきい値に対して評価するアラーム、システムヘルスを可視化するダッシュボードを提供します。CloudWatch 推奨アラームは、マネージドサービスのベストプラクティスメトリクスとしきい値を特定するのに役立ちます。
一般的な成果:
- インシデント対応時間の短縮
- チーム間のコラボレーションとナレッジ共有の改善
- 標準化された運用手順
- データドリブンな意思決定の基盤
ステージ 3:統合・自動化されたオブザーバビリティ
これは、組織が洗練されたツール、自動化、機械学習をオペレーショナルエクセレンスのために活用する成熟したプラクティスを表します。オブザーバビリティは、技術的な運用とビジネス戦略の両方に深く統合されます。
主な特徴:
-
相関テレメトリを持つ依存関係グラフ — Amazon CloudWatch Application Signals、Application Maps、AWS X-Ray トレースマップを使用して、サービス、依存関係、クロスアカウントのインタラクションを自動的に検出・可視化します。これにより、インシデント時の影響範囲を迅速に評価できます。
-
修復の自動化 — Amazon EventBridge、AWS Lambda、AWS Systems Manager を含む AWS サービスをオーケストレーションし、アラート条件に基づいて自動修復をトリガーします。
-
アラート疲労の軽減 — アラートを重要なサービス、SLO、顧客に影響を与える動作にマッピングします。関連する条件をグループ化・相関させ、動的しきい値を適用し、メンテナンスウィンドウ中のアラートを抑制します。
-
組み込みの機械学習と AIOps — CloudWatch Anomaly Detection は正常なベースラインを学習し、静的しきい値なしで異常な動作を検出します。CloudWatch Log Anomaly Detection はパターンをクラスタリングし、新しいまたは予期しないエラーを特定します。X-Ray Insights はアプリケーションパフォーマンスの異常を検出します。CloudWatch Investigations はインシデント対応のための生成 AI 駆動のアシスタンスを提供します。
-
システムヘルスとビジネス成果の相関ダッシュボード — テレメトリを技術的およびビジネスインパクトの両方のレンズで表示するため、レイテンシースパイクがユーザージャーニーの劣化やトランザクション完了率の低下として即座に可視化されます。
一般的な成果:
- 手動の運用オーバーヘッドの大幅な削減
- プロアクティブな問題防止と予測
- 技術的意思決定のビジネスインパクトの明確な可視性
- 信頼性の向上によるカスタマーエクスペリエンスの改善
アンチパターンと一般的な落とし穴
オブザーバビリティを一度きりのイニシアチブとして扱う
オブザーバビリティを終了日が決まった有限のプロジェクトとして位置付けると、古くなったダッシュボード、ミスアラインメントまたはサイレントなアラーム、新しいサービスの導入時の不完全なカバレッジにつながります。オブザーバビリティは永続的な機能として管理する必要があり、アーキテクチャの進化と変化する要件に結び付けた定期的なレビューと反復的な強化が必要です。
段階的なクロール・ウォーク・ランのアプローチに従わない
早期に非常に複雑なオブザーバビリティスタックを設計すること(例えば、大規模なカスタムエンリッチメントを伴うマルチリージョン、マルチテナントのテレメトリパイプライン)は、実証されたビジネス価値なしに重大な運用オーバーヘッドを導入します。まず最小限だが堅牢なベースラインを確立し、ワークロードの複雑さが追加投資を正当化するにつれて、高度な機能を段階的に導入します。
明確な目的なしに大量のテレメトリを収集する
定義されたユースケースなしにすべてのログ、メトリクス、トレースをフル忠実度で取り込むと、過剰なカーディナリティ、クエリパフォーマンスの劣化、高いストレージコストが発生します。明示的な目標を定義し、テレメトリ収集をそれらの目標にスコープし、サンプリング、集約、フィルタリング戦略を適用します。例えば、非必須のラベル(詳細なリクエスト ID、動的なユーザー識別子)を削減することで、カーディナリティを制御し、コストを下げ、クエリを高速化できます。
単一のオブザーバビリティベンダーへの早期ロックイン
計装ライブラリ、データスキーマ、ランブックを早い段階で単一のベンダーに結合すると、データ量の増加に伴い移行リスクが増大し、柔軟性が制限されます。計装とデータ転送に OpenTelemetry のようなオープン標準に準拠したマネージドサービスを使用します。これにより、大規模な再計装なしにコスト効果の高いオプションへの移行やオブザーバビリティツールの多様化が可能になります。
ツール中心モデルではなく文化中心モデルを採用する
エンジニアリングチームがコードパスを積極的に計装し、ワークフローでテレメトリを使用することなく、サービス(CloudWatch、X-Ray、またはサードパーティ APM)を単に有効化するだけでは、効果的なオブザーバビリティは得られません。チームは、ヘルスシグナルを定義・所有し、ダッシュボードをインシデント対応に組み込み、テレメトリを設計とキャパシティプランニングに活用することで、開発と運用にオブザーバビリティを組み込む必要があります。
テレメトリとメタデータ標準のガバナンスの欠如
各チームがメトリクス名、ラベルセット、ログフォーマット、トレース属性を独立して定義すると、結合や相関が困難な断片化されたデータセットが生成されます。標準化された命名規則、必須のディメンション(サービス、環境、リージョン、テナント)、共通ライブラリとテンプレートによる共有スキーマを含むテレメトリガバナンスを確立・適用します。
顧客中心およびユーザーエクスペリエンス指標の軽視
インフラストラクチャレベルのシグナル(CPU、メモリ、ディスク)に主に焦点を当て、ユーザー中心およびビジネス KPI を省略すると、実際の顧客への影響が不明瞭になります。API はホストレベルでは正常に見えても、主要フローのレイテンシーやエラー率の上昇により、顧客が劣化したジャーニーを体験している場合があります。これらのシグナルをユーザーエクスペリエンスに結び付けたファーストクラスの SLO としてモデル化します。
データ保持とティアリングポリシーの未定義
ログとメトリクスのデフォルトまたは無制限の保持に依存すると、ストレージと分析コストが制御不能に増大します。テレメトリクラスごとに段階的な保持ポリシーを定義します:インシデント対応のための短期高解像度データ、長期トレンド分析のためのダウンサンプリングされたメトリクス、古いデータのアーカイブまたはパージのためのライフサイクルルールです。
進行に関する考慮事項
これらのステージの進行は厳密に線形ではありません。組織は複数のステージの特徴を同時に示す場合があります。適切なペースは以下に依存します:
- 成長率とスケーリング要件
- 利用可能なエンジニアリングリソースと専門知識
- 予算の制約と投資の優先順位
- 規制とコンプライアンスの義務
現在の状態を評価し、ビジネスインパクトに基づいて改善を優先し、運用ニーズと戦略目標に合わせてオブザーバビリティを段階的に進化させるために増分的に投資します。
関連リソース
- オブザーバビリティ戦略 — オブザーバビリティをビジネス成果に結び付けるリーダー向けの戦略的ガイダンス
- オブザーバビリティ成熟度モデル — 成熟度レベルを評価するための段階的評価モデル
- AWS Well-Architected オペレーショナルエクセレンスの柱